Seedance 2.5, Wan 3.0 e InfiniteTalk: teste de lip-sync
Comparei Seedance 2.5, Wan 3.0 e InfiniteTalk com o mesmo trecho de uma música cantada em polonês: veja os resultados, custos e tempos.
👁 115 leituras
Testei ferramentas de lip-sync com IA usando o mesmo trecho de uma música em polonês e o mesmo enquadramento da personagem. O Seedance 2.5 gerou a imagem de que mais gostei, mas teve o pior resultado na sincronização dos lábios com o vocal. O Wan 3.0 foi o caminho mais rápido para obter um playback utilizável, embora o limite de duração tenha sido um obstáculo. O InfiniteTalk rodando localmente teve a melhor pontuação na medição, mas exigiu mais tempo.
Resumo
Na comparação dos primeiros 15 segundos, o InfiniteTalk teve correlação de 0,471, o Wan 3.0 chegou a 0,419 e o Seedance 2.5 terminou com 0,153. Esse indicador mede a correspondência entre a abertura da boca e o volume do vocal, não a porcentagem de palavras cantadas corretamente. Para uma cena focada em playback, eu escolheria o InfiniteTalk. Usaria o Seedance como base visual para um tratamento posterior.
O mesmo trecho e a mesma personagem
Para o teste, escolhi o trecho “Quando canto do meu jeito” - tradução do título original em polonês “Kiedy po swojemu gram” - entre 14,5 e 34,5 segundos. Ele inclui o segundo refrão, a entrada da bateria e o começo da estrofe. Assim, não avaliei apenas uma vogal sustentada e tranquila. O trecho muda de energia, o que facilita perceber se o rosto reage ao canto ou apenas faz uma animação chamativa.
O ponto de partida foi o mesmo enquadramento da personagem, preparado localmente com o Z-Image Turbo. Nas versões via API, usei uma referência de áudio pelo mecanismo TAKT. A versão local usou o InfiniteTalk pelo WanVideoWrapper, com o modelo-base Wan 2.1 I2V 14B fp8 e lightx2v em 6 etapas. Esta é uma comparação entre configurações específicas, não entre todos os recursos desses modelos.
Eu planejava comparar os 20 segundos completos, mas o Wan 3.0 não concluiu uma solicitação com essa duração. Por isso, os primeiros 15 segundos foram o trecho comum da medição. Não incluí no ranking os resultados de trechos mais longos. Caso contrário, estaria comparando modelos com materiais de conteúdo diferente, e a tabela pareceria mais confiável do que o método permite.
Como medi o lip-sync com o MediaPipe
No script lipsync_pomiar.py, comparei a abertura da boca detectada pelo MediaPipe com o volume do vocal isolado pelo demucs. Procurei um deslocamento de até ±0,5 segundo. Uma correlação mais alta indica uma correspondência melhor entre esses sinais segundo o método adotado. Isso permite separar a reação geral do rosto à voz da impressão de que a personagem está “cantando alguma coisa”.
Essa medição tem limitações. O volume não descreve o formato exato da boca exigido por cada som do polonês. O fechamento dos lábios, a articulação das consoantes e a naturalidade das expressões precisam de uma avaliação visual complementar. Portanto, não interpreto a correlação como uma avaliação automática da pronúncia nem como prova de que o público acreditará que a personagem cantou a música inteira.
Também registrei a detecção de rostos. InfiniteTalk e Wan tiveram 100% no registro, enquanto o Seedance ficou entre 69% e 76%. Uma menor disponibilidade de rostos limita a abrangência da medição e dificulta conclusões diretas. Não atribuo uma causa às detecções ausentes, porque o relatório não esclarece o motivo. Considero esse indicador junto com a análise visual, em vez de tratá-lo como uma conclusão independente.
A busca por deslocamento também significa que o resultado descreve a correspondência entre os sinais depois desse alinhamento. Não prova que o arquivo baixado do gerador já tenha o início da faixa perfeitamente sincronizado. Ao montar a cena final, verifico separadamente o deslocamento constante e se a correspondência se mantém nas frases seguintes. Deslocar todo o áudio pode melhorar o início, mas não substitui uma animação de boca adequada ao longo da música.
Resultados, custos e tempo de espera
| Versão | Lip-sync, 15 s | Custo registrado no teste | Tempo |
|---|---|---|---|
| InfiniteTalk local | 0,471 | Sem taxa de geração; energia à parte | 1284 s |
| Wan 3.0 via API | 0,419 | 1,0594 USD | 330 s |
| Seedance 2.5 via API | 0,153 | 5,3365 USD | 316 s |
Os tempos correspondem aos clipes recebidos: o material local e o do Seedance tinham 20 segundos, enquanto o do Wan tinha 15 segundos. A duração comum vale para a coluna de medição da sincronização. Os valores são os custos deste teste, não uma tabela de preços válida para qualquer data. Não acrescento o custo da energia porque não fiz essa medição.
As configurações de imagem também foram diferentes. O InfiniteTalk gerou 832×480 a 25 quadros por segundo, o Wan gerou 1280×720 a 30 quadros por segundo e o Seedance, 1280×720 a 24 quadros por segundo. Essas diferenças precisam ser consideradas na edição. Neste comparativo, porém, a resolução mais alta não resultou em melhor sincronização dos lábios com a música.
Seedance: a imagem mais bonita e o problema do áudio próprio
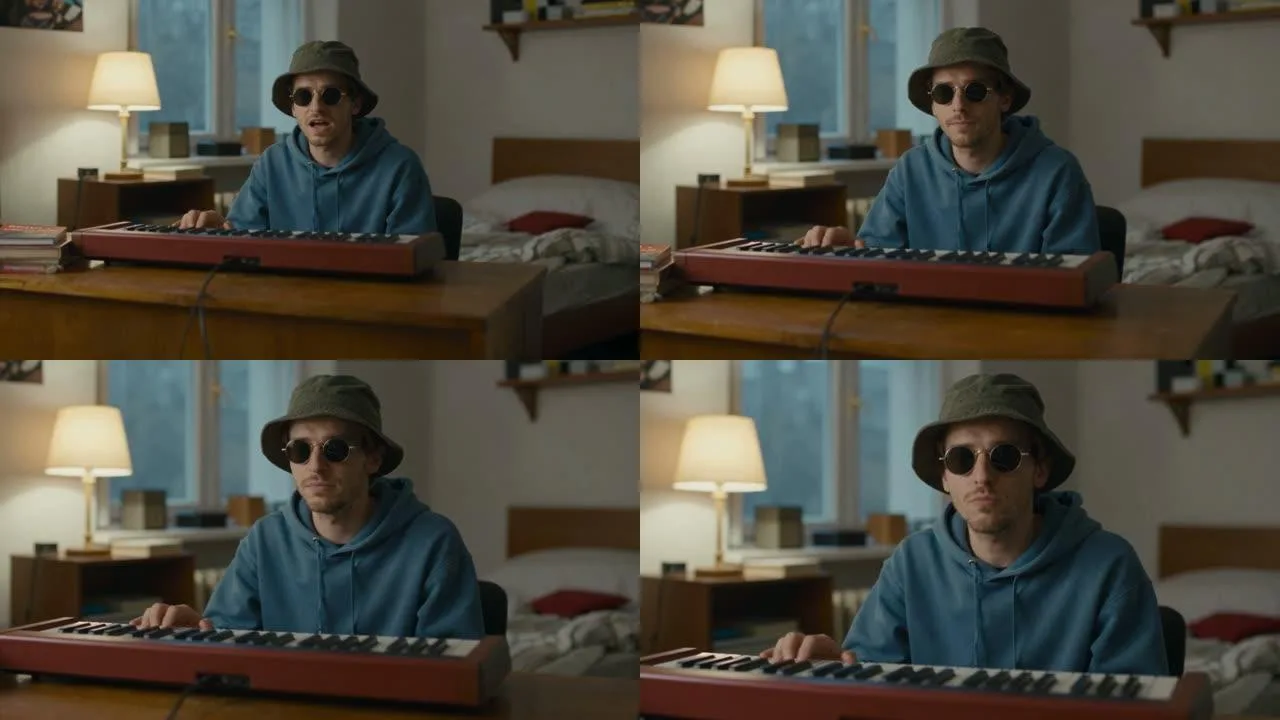
No Seedance, gostei mais da iluminação, da composição e da impressão geral de cena pronta. Essa é uma avaliação visual, separada da medição de sincronização. Um enquadramento bonito pode facilmente desviar a atenção da boca, sobretudo quando o vídeo é visto sem a música original. Quando comparei a imagem com o vocal correto, a vantagem estética deixou de ser suficiente.
O modelo gerou uma versão própria da faixa de áudio. A correlação dela com o original foi de 0,12. Neste material, foi necessário substituir o áudio pelo original, levando em conta o deslocamento de cerca de 47 ms registrado nas anotações. Eu não aplicaria esse deslocamento automaticamente a outros clipes. A faixa gerada pelo modelo não deve substituir a master da música só porque veio junto com a imagem.
Wan 3.0: playback utilizável, mas limitado a 15 s neste teste
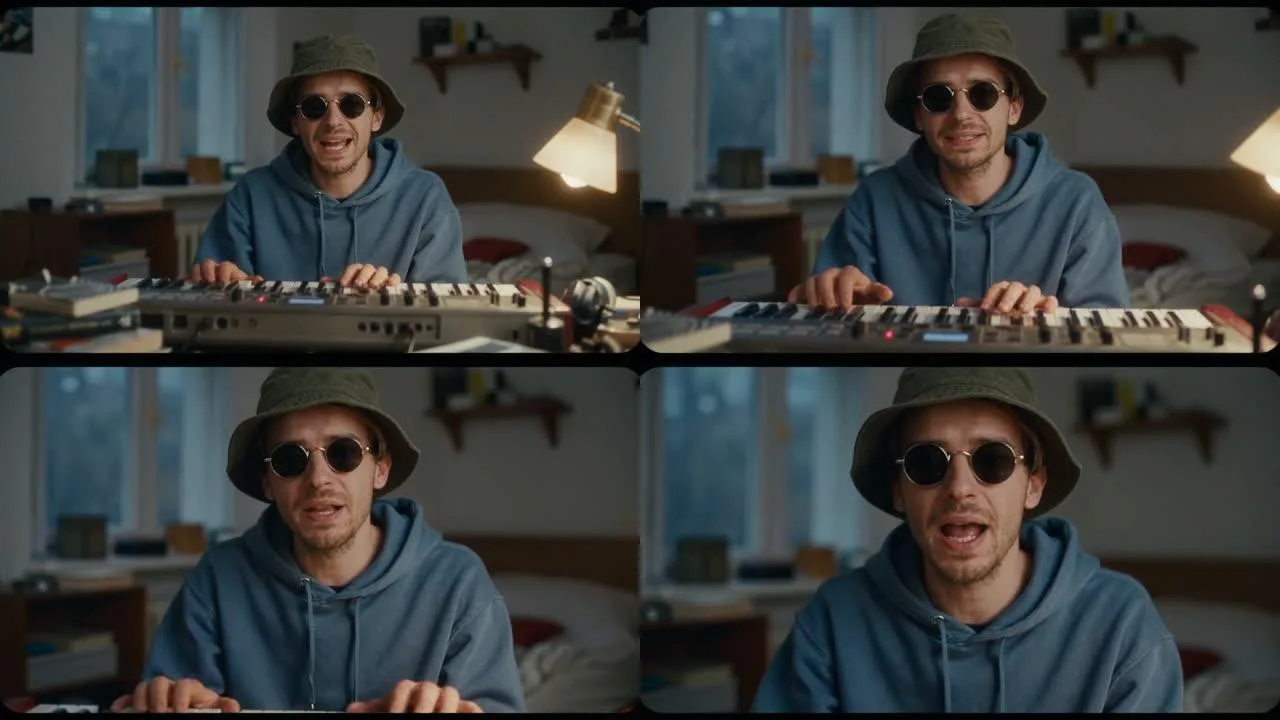
O Wan teve uma correlação melhor que a do Seedance e custou menos neste teste. O problema mais prático surgiu antes mesmo da avaliação visual: a solicitação de 20 segundos terminou com a mensagem generation_failed, sem cobrança. Só a solicitação de 15 segundos funcionou. É assim que interpreto o limite observado: como uma restrição do fluxo de API testado, não como prova sobre todas as integrações possíveis.
Ao planejar um videoclipe, eu prepararia trechos mais curtos e pontos de corte para a edição. Não presumiria que uma frase mais longa vai funcionar só porque o campo de duração aceita o valor solicitado. Gerar a imagem com sucesso e ajustar os limites do clipe à música são tarefas diferentes, que precisam ser consideradas antes de enviar a próxima solicitação.
InfiniteTalk vence na medição, e o V2V oferece outro caminho
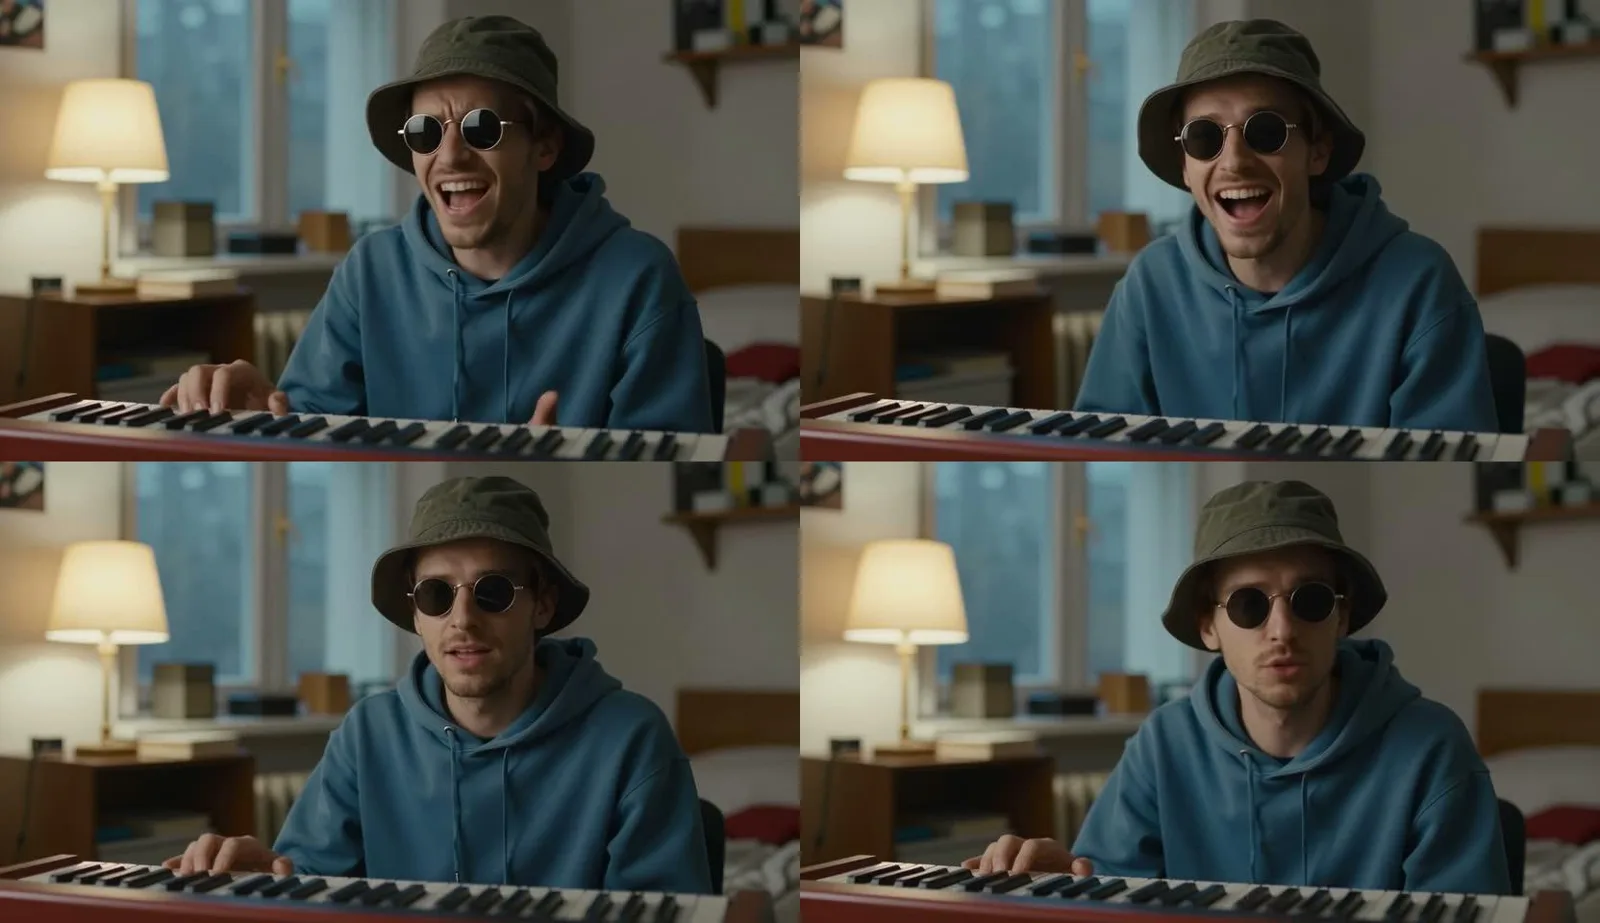
O InfiniteTalk local teve a maior correlação no trecho comum. Nos 20 segundos completos, o resultado foi 0,424. Recebi uma resolução menor e precisei esperar mais pelo processamento, mas, para animar o canto de um trecho específico, foi um ponto de partida melhor. Isso não significa que a articulação de todas as palavras tenha ficado perfeita.
Também testei combinar o Seedance com o InfiniteTalk local no modo V2V. Com 2 de 4 etapas e audio_scale em 1,5, a correlação subiu de 0,153 para 0,366. A detecção de rostos ficou em 77%, e essa etapa adicional levou 656 segundos. O resultado foi um vídeo em 832×480, então a melhora no playback exigiu aceitar uma mudança nas configurações de imagem.
Esse fluxo não superou o InfiniteTalk sozinho na medição, mas permitiu aproveitar uma imagem gerada anteriormente pela API. Depois, o SeedVR2 7B fp8 aumentou a resolução para 1872×1080 em mais 1034 segundos. Considero isso uma forma de finalizar a cena escolhida. O upscaling não comprova uma melhora adicional na sincronização.
Perguntas frequentes
Qual modelo eu escolheria para cantar em polonês?
Com base neste teste, escolheria o InfiniteTalk se o mais importante fosse o playback. Consideraria o Wan para cenas mais curtas e quando precisasse de um resultado mais rápido. Deixaria o Seedance para imagens que justificassem uma correção adicional da boca.
A maior correlação significa lip-sync perfeito?
Não. Medi a relação entre a abertura da boca e o volume do vocal, não a pronúncia correta de todos os sons. O resultado ajuda a comparar este teste, mas não substitui assistir ao clipe com a mixagem original.
A geração local é gratuita?
O relatório registra que não houve taxa de geração. Ainda há os custos de energia, equipamento e tempo para preparar o ambiente. Sem medir o consumo de energia, não informo um custo total nem prometo economia para qualquer quantidade de clipes.
Expliquei preços e acesso aos modelos nos artigos sobre Seedance e Wan 3.0. Para planejar as cenas de um clipe inteiro, veja também o artigo sobre Kling 4.0 para videoclipes.
Fontes e data da verificação
Medições, tempos e custos: registro do teste klipy-ai-test/WYNIKI.md. Configurações: opus-wideo/KLIPY-AI-REPO.md e ficha infinitetalk.md. As imagens vêm do mesmo teste. Documentação dos projetos: InfiniteTalk e WanVideoWrapper. As conclusões se referem ao material e às configurações descritos.
Verificado em 21 de outubro de 2026.
Tópicos relacionados no Centelharm