InfiniteTalk no ComfyUI com RTX 4090: instalação e ajustes
Testei o InfiniteTalk no ComfyUI com uma RTX 4090: veja os modelos fp8, o tempo de geração e como lidei com erros de transformers, torchaudio e LoRA.
👁 117 leituras
Testei o InfiniteTalk no ComfyUI com uma RTX 4090 usando um trecho de uma música polonesa. O clipe local teve 20 s, e o processamento levou 1.284 s, ou pouco mais de 21 minutos. No caminho, encontrei problemas com transformers, torchaudio e a mesclagem de LoRA. Neste artigo, descrevo a configuração que funcionou e os arquivos necessários para montá-la, diferenciando o registro do teste das sugestões de ajustes de memória.
Resumo
Usei o WanVideoWrapper, o modelo base Wan 2.1 I2V 14B fp8, o InfiniteTalk e o lightx2v com 6 etapas. O resultado em 832×480 a 25 fps teve correlação de sincronização labial de 0,471 nos primeiros 15 s. Os principais ajustes no ambiente envolveram hidden_states no wav2vec, a compatibilidade entre torchaudio e torch e a configuração merge_loras=False. É um caso funcional nessa placa, sem garantia de que outro ambiente terá o mesmo tempo de processamento.
O que instalar no ComfyUI
Usei o InfiniteTalk por meio do ComfyUI-WanVideoWrapper. Esse complemento integra o carregamento do modelo de vídeo, do módulo InfiniteTalk e da representação de áudio. A configuração descrita usa como base o Wan 2.1 I2V, então não substituí esse modelo por outra família Wan mais recente. O fato de os modelos terem o mesmo fabricante não significa que todos os pesos e nós sejam compatíveis.
Para montar a instalação, coloco o repositório do wrapper na pasta custom_nodes da instalação do ComfyUI que uso. Instalo as dependências de requirements.txt com o interpretador vinculado à mesma instalação do ComfyUI. Evito instalar pacotes com um pip qualquer do sistema, pois a biblioteca pode estar no computador e ainda assim não ficar acessível ao aplicativo.
Depois de instalar o complemento e reiniciar o ComfyUI, carrego o workflow de exemplo do InfiniteTalk. Antes de baixar outros checkpoints, verifico se há nós ausentes. O exemplo da documentação usa outra variante de pesos; para usar fp8, é preciso escolher conscientemente o loader e os arquivos. Renomear um checkpoint não o converte.
Modelos fp8 e tamanho dos arquivos
A tabela abaixo reúne a configuração descrita na página da ferramenta. Os tamanhos vêm dos metadados salvos no Hugging Face, não de medições de uso da placa. Os GB são decimais. Não somo esses valores para estimar a VRAM necessária, pois o offload, os buffers e a ordem de execução dos nós alteram o uso de memória durante o processamento.
| Função | Arquivo | Tamanho |
|---|---|---|
| Modelo base de vídeo | Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors |
16,643 GB |
| Módulo InfiniteTalk | Wan2_1-InfiniteTalk-Single_fp8_e4m3fn_scaled_KJ.safetensors |
2,714 GB |
| Encoder de texto | umt5-xxl-enc-fp8_e4m3fn.safetensors |
6,731 GB |
| VAE | Wan2_1_VAE_bf16.safetensors |
0,254 GB |
| Encoder de áudio | wav2vec2-chinese-base_fp16.safetensors |
0,190 GB |
| CLIP Vision | clip_vision_h.safetensors |
1,264 GB |
Coloco o modelo base e o módulo InfiniteTalk em models\diffusion_models, o encoder de texto em models\text_encoders, o VAE em models\vae e o CLIP Vision em models\clip_vision. O local do wav2vec depende do loader de áudio. Não o coloco na pasta do encoder de texto só porque os dois componentes processam dados de entrada.
No workflow, verifico se estão presentes WanVideoModelLoader, MultiTalkModelLoader, Wav2VecModelLoader, MultiTalkWav2VecEmbeds, WanVideoImageToVideoMultiTalk, WanVideoSampler e WanVideoVAELoader. O checkpoint completo da implementação nativa do InfiniteTalk não substitui automaticamente o módulo menor carregado por MultiTalkModelLoader. Confiro as diferenças entre os formatos antes de executar o grafo.
Lightx2v, voz e tempo de processamento na RTX 4090
No teste registrado, usei lightx2v e 6 etapas. Não apresento esse número como configuração universal para o modelo Wan base sem complementos. O sampling reduzido deve ser avaliado junto com o complemento e a configuração adequados. O relatório não informa o nome completo do arquivo de LoRA usado, então não acrescento um checkpoint específico como se estivesse confirmado.
Para a comparação, escolhi um trecho de 14,5 a 34,5 s da música polonesa “Kiedy po swojemu gram” (título original). Ao preparar a entrada, sincronizo o início da imagem com o da voz e, no final, junto o clipe à mixagem original. A voz isolada ajuda a controlar as expressões faciais; ela não deve substituir por engano a música completa no material final.
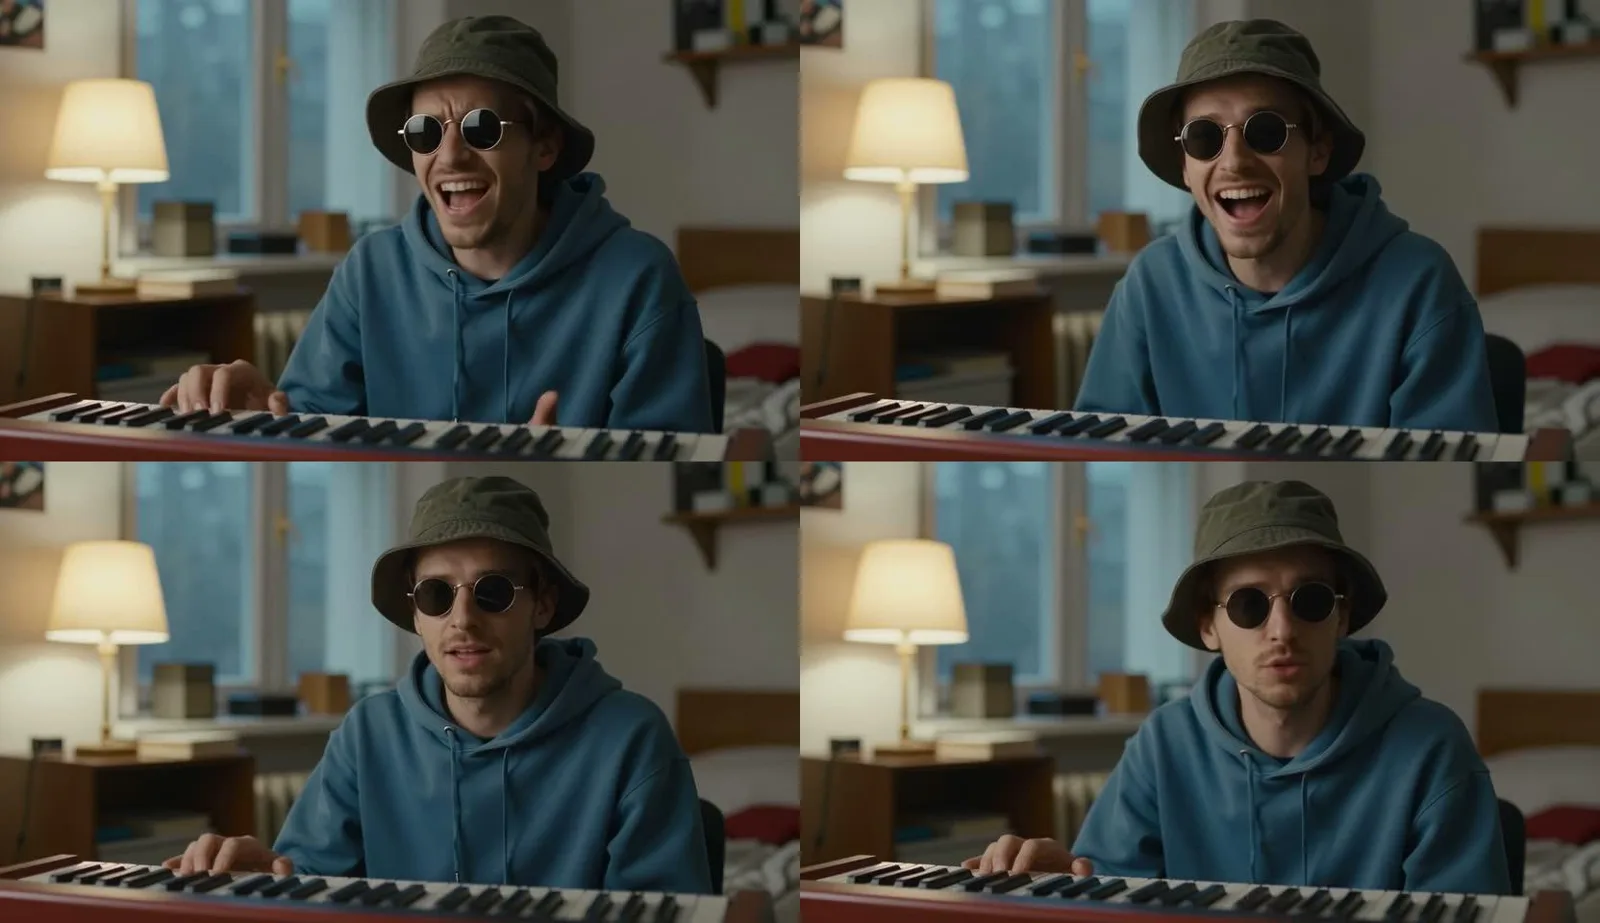
O tempo de 1.284 s corresponde a um clipe de 20 s. A correlação entre a abertura da boca e o volume da voz foi de 0,471 nos primeiros 15 s em comum e de 0,424 no trecho completo. O rosto foi detectado em 100% dos quadros. Essa medição foi feita com MediaPipe e voz isolada pelo demucs; não é uma avaliação da pronúncia de todos os fonemas do polonês.
A página da ferramenta sugere o offload do encoder de texto, o block swap e a decodificação separada do VAE. Trato essas opções como sugestões para gerenciar a memória, pois o relatório não registra um preset completo nem o pico de uso de VRAM. O fato de a configuração ter funcionado na RTX 4090 não permite garantir que qualquer duração, resolução e grafo também funcionarão sem problemas.
Transformers 5.x: correção relacionada a hidden_states
O wrapper precisou de uma correção para o transformers 5.17, relacionada ao tratamento de hidden_states pelo componente wav2vec. No registro do teste, o nome da cópia do arquivo original era nodes.py.orig-2110. Esse detalhe é uma pista útil para diagnosticar ambientes que carregam os modelos, mas travam ao processar áudio. O problema estava na interação entre bibliotecas, não na letra polonesa da música.
As anotações não incluem o diff dessa correção. Por isso, não invento um trecho de código nem números de linha para substituir. Para reproduzir essa configuração, é necessário ter o registro da correção ou usar uma versão compatível do wrapper e do transformers. Dizer apenas “atualize tudo” não descreve o conserto que confirmei no teste.
Torchaudio, merge_loras e execução no Windows
Na configuração funcional, usei o torchaudio nightly 2.11 com torch 2.14 cu132. Essas versões registram o ambiente do teste; não são uma recomendação de atualização indiscriminada para toda instalação. Se houver problemas na importação de áudio, comparo o interpretador, a versão do torch e o pacote torchaudio correspondente antes de alterar os pesos do modelo.
O segundo obstáculo foi a mesclagem de LoRA. A mesclagem causava um access violation no Windows, então usei merge_loras=False. Essa diferença importa: desativei a mesclagem, não a própria LoRA. Remover o complemento e manter o sampling curto mudaria a configuração cujo resultado descrevo.
Executei o ComfyUI com PYTHONUTF8=1. Para reproduzir o ambiente, defino essa variável antes de iniciar o processo. Também registro as versões dos pacotes e preservo o workflow funcional, pois uma mudança posterior nas dependências pode dificultar a identificação da origem de um problema: áudio, carregamento do modelo ou execução do sampler.
V2V: como melhorar os movimentos da boca em um clipe pronto
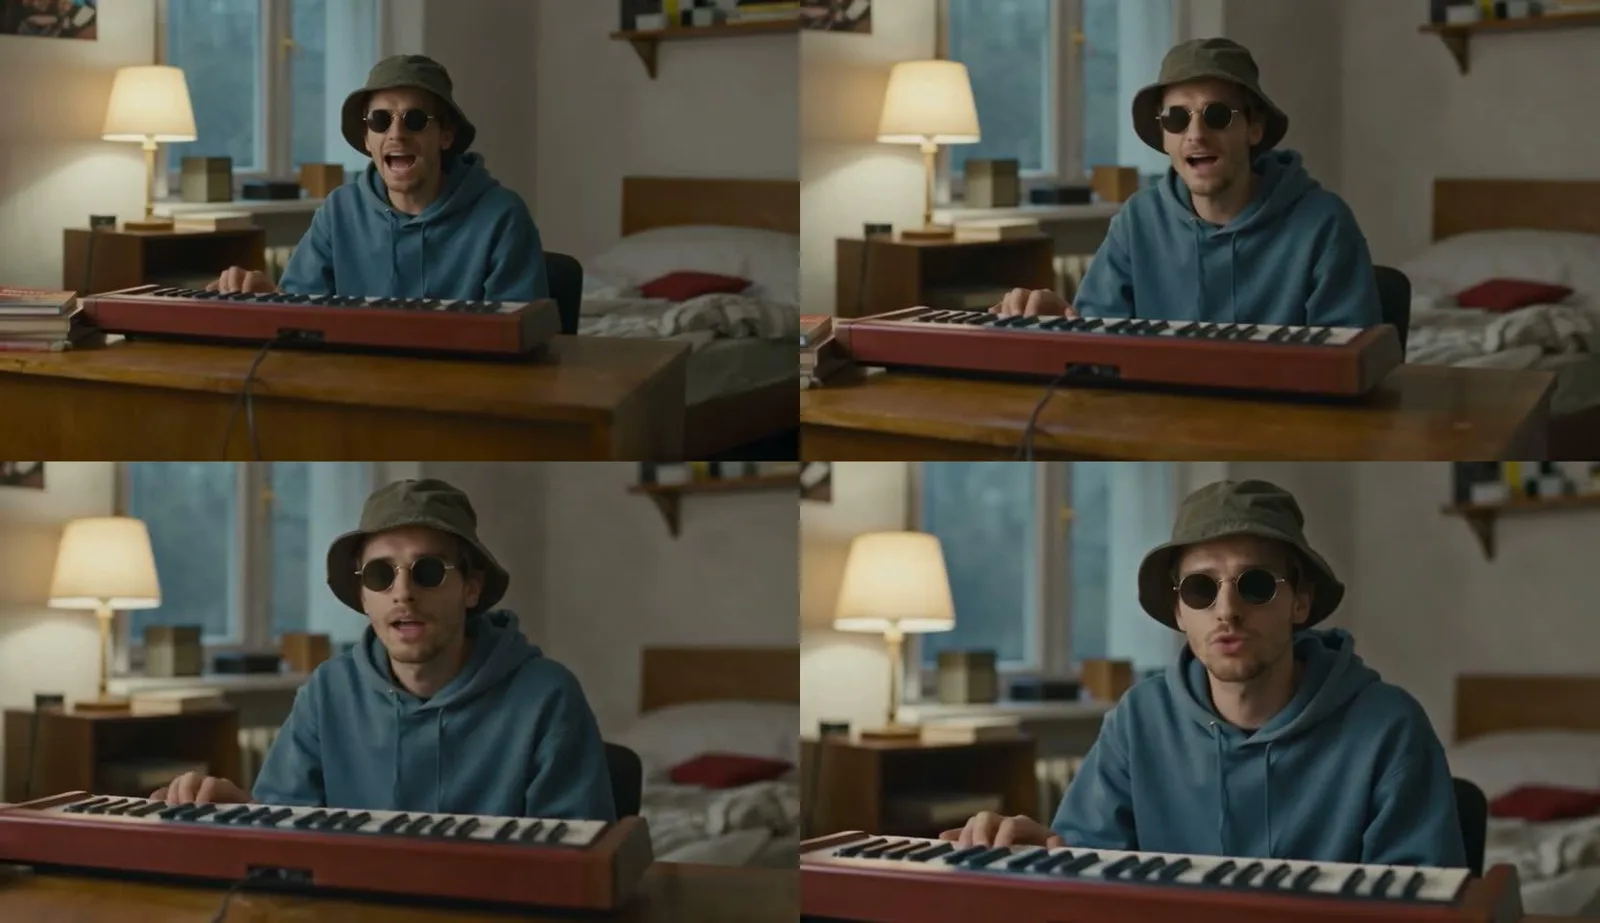
Também testei V2V em um vídeo gerado com Seedance 2.5. Com 2 de 4 etapas e audio_scale em 1,5, o processamento adicional levou 656 s. A correlação subiu de 0,153 para 0,366, e a detecção de rosto foi de 77%. O resultado teve resolução de 832×480. Essa é uma configuração separada; não misturo seus ajustes com os do teste base com lightx2v.
O InfiniteTalk V2V pode alterar a expressão facial e o movimento, não apenas a região da boca. Por isso, depois do processamento, também comparo a identidade da personagem e o estilo da apresentação. Um indicador de sincronização melhor não basta se eu perder elementos visuais que motivaram a escolha do clipe original. Manter uma cópia da entrada facilita essa avaliação.
Licenças dos componentes
Na documentação consultada, o InfiniteTalk, o WanVideoWrapper e o modelo base Wan 2.1 usam a licença Apache-2.0. O encoder TencentGameMate e a conversão indicada de Kijai declaram a licença MIT, enquanto o ComfyUI é descrito como GPL-3.0. Verifico separadamente as condições do código, dos pesos e dos complementos. A licença do wrapper não se aplica automaticamente a todos os modelos carregados.
Na lista, o repositório LightX2V usa a licença Apache-2.0, mas a falta do nome completo da LoRA usada limita a identificação do arquivo específico. O separador de voz adicional também precisa ser verificado separadamente. Não atribuo restrições da família Hunyuan ao encoder wav2vec apenas por causa do nome Tencent.
Perguntas frequentes
O InfiniteTalk funciona com uma música em polonês?
Na configuração descrita, obtive um resultado útil. Testei um trecho específico de canto, então não generalizo a conclusão para todas as vozes, velocidades e articulações.
Os 21 minutos incluem a instalação?
Não. Os 1.284 s registrados correspondem ao processamento do clipe. O relatório não traz medições separadas para baixar os pesos, preparar o ambiente ou diagnosticar erros.
Posso copiar a correção pronta do transformers?
O registro compartilhado não contém o código da correção. Ele informa a área alterada e o nome da cópia do arquivo original. Para reproduzir a configuração, é necessário obter o diff correto, não substituir o arquivo por tentativa.
Se você está começando, veja primeiro ComfyUI: instalação no Windows e Wan 2.2 local. Também escrevo sobre modelos executados na sua própria placa no guia de IA local.
Fontes e data do teste
- Medições e erros: meu teste com RTX 4090, 21/10/2026
- InfiniteTalk: repositório e licença
- Pesos fp8 de Kijai (Hugging Face)
- Workflow do wrapper indicado acima no texto
Os dados correspondem ao estado registrado durante o teste.
Verificado em 21 de outubro de 2026.
Tópicos relacionados no Centelharm