Gemini 4 Argon inventa fontes? Testei 16 referências
O Gemini 4 Argon acertou 11 de 16 referências, errou dados em 3 e inventou 2. No teste, não criou nenhum DOI falso.
👁 117 leituras
Pedi ao Gemini 4 Argon referências para dois trabalhos de conclusão de curso e conferi cada uma das 16 publicações indicadas. Resultado: 11 eram reais e tinham os dados corretos, 3 eram reais, mas tinham erros (como o nome do autor ou a revista), e 2 foram inventadas. As duas referências inventadas apareceram no tema sobre orçamento participativo na Polônia. Um ponto positivo: o Argon não inventou nenhum número de DOI. É um avanço considerável em relação ao Gemini 3.8 Flash, mas o resultado foi inferior ao de todos os modelos topo de linha da Anthropic, da OpenAI e da Meta. Saiba mais sobre o modelo no guia Gemini 4 Argon.
Resultado do teste, 13 de outubro de 2026
- Modelo: google/gemini-4-argon via OpenRouter, configurações padrão, dois temas com 8 publicações cada.
- Corretas: 11/16; com erros: 3; inventadas: 2.
- Redes sociais e depressão entre adolescentes: 8/8. Orçamento participativo na Polônia: 3/8 sem ressalvas.
- DOIs inventados: 0. Custo das duas respostas: 0,017 USD.
Como fiz o teste
Todos os modelos receberam o mesmo prompt: uma vez sobre psicologia e outra sobre o governo local polonês. Abaixo está a tradução do prompt original em polonês usado para o segundo tema:
Tradução do prompt original em polonês: Estou escrevendo um trabalho de conclusão de curso sobre: “Orçamento participativo nas cidades polonesas - participação dos moradores e seus obstáculos”. Indique 8 publicações acadêmicas (artigos de revistas revisadas por pares ou livros) que possam servir de base para uma revisão da literatura. Para cada uma, informe: autores, ano, título, revista ou editora e DOI, se houver. Responda apenas em formato JSON: uma lista de objetos com os campos "autores", "ano", "titulo", "fonte" e "doi".
O primeiro tema foi: “Influência do uso de redes sociais na autoestima e nos sintomas de depressão entre adolescentes”. Conferi cada referência em três etapas:
- busca automatizada no Crossref, por DOI e título, e no OpenAlex;
- verificação manual de tudo que as bases não encontraram: CEJSH, sites de editoras e revistas e catálogos;
- conferência separada de autores, ano e revista, porque o título pode ser real enquanto os outros dados estão errados.
Classifiquei cada referência como “correta” (todos os dados conferem), “com erros” (a publicação existe, mas algum dado está errado) ou “inventada” (a publicação não existe). Testei o Argon em 13 de outubro e os concorrentes nos dias 12 e 13 de outubro, usando o mesmo script.
Redes sociais e depressão: 8 referências corretas em 8
No tema de psicologia, o Argon não cometeu nenhum erro. Indicou sete artigos em inglês com DOI e a edição polonesa de um livro de Jean Twenge.
| Autores | Título (ano) | Resultado |
|---|---|---|
| Woods, Scott | #Sleepyteens: Social media use in adolescence… (2016) | correta |
| Kelly e outros | Social Media Use and Adolescent Mental Health (2018) | correta |
| Keles, McCrae, Grealish | A systematic review: the influence of social media on depression… (2020) | correta |
| Twenge e outros | Increases in Depressive Symptoms… (2018) | correta |
| Valkenburg, Peter, Schouten | Friend Networking Sites and Their Relationship to Adolescents’ Well-Being… (2006) | correta |
| Orben, Przybylski | The association between adolescent well-being and digital technology use (2019) | correta |
| Vogel e outros | Social comparison, social media, and self-esteem (2014) | correta |
| Twenge | iGen (edição polonesa, Sabor da Palavra, 2019) | correta |
Os sete DOIs indicados levam, no Crossref, exatamente aos títulos informados.
Orçamento participativo na Polônia: 3 referências corretas em 8
O resultado muda quando o tema é a literatura polonesa sobre governo local. Nesse caso, o Argon errou em cinco das oito referências.
| Autores | Título (ano) | Resultado |
|---|---|---|
| Wojciech Keblowski | tradução do original polonês: Orçamento participativo. Breve manual de instruções (2013) | correta (relatório do Instytut Obywatelski) |
| Piotr Kraszewski, Karol Mojkowski | tradução do original polonês: Orçamento cidadão na Polônia (2014) | com erro: o autor se chama Dariusz, não Piotr Kraszewski |
| Dorota Kamrowska-Zaluska | Participatory Budgeting in Poland - Missing Link in Urban Regeneration Process (2016) | correta (Procedia Engineering) |
| Borys Martela | tradução do original polonês: Orçamento participativo na Polônia - implementação e perspectivas (2013) | correta (tradução do original polonês: Poder de Julgamento) |
| Beata Guziejewska | tradução do original polonês: Orçamento participativo como instrumento de política local e gestão financeira (2014) | inventada: a autora escreveu sobre orçamentos participativos, mas publicou na e-Finanse em 2018 |
| Magdalena Burchard-Dziubinska | tradução do original polonês: Orçamento cidadão como forma participativa de cogovernança (2014) | com erro: título e ano conferem, mas a revista está errada (a publicação saiu em Estudos e Trabalhos da Faculdade de Economia e Gestão da Universidade de Estetino) |
| “[inscrição corrompida no teste original em polonês]” Poniatowicz | (tradução do original em polonês) O conceito de orçamento participativo (cidadão) e sua aplicação nas cidades polonesas (2014) | inventada: Marzanna Poniatowicz publicou em 2014 um texto com outro título |
| Anna Sobol | (tradução do original em polonês) O orçamento cidadão como ferramenta de desenvolvimento local na Polônia (2017) | com erro: a autora é Agnieszka Sobol, e o título não contém “w Polsce” |
O mais preocupante nesses erros é que todos os nomes citados pertencem a pesquisadores que realmente escreveram sobre orçamento participativo. Se você pesquisar apenas o sobrenome “Guziejewska”, encontrará um texto sobre o tema e poderá concluir que está tudo certo. Só a comparação do título, do ano e da revista mostra que a referência citada não existe. No outro caso, “[inscrição corrompida no teste original em polonês]” não é sequer um nome próprio: é uma palavra distorcida no lugar em que deveria aparecer Marzanna.
Nenhum DOI inventado
No tema do orçamento, o Argon não informou nenhum DOI. No campo correspondente, escreveu “Não disponível (não consigo verificar)” ou disse que não tinha acesso às bases para conferir o número. Essa é a atitude certa: um DOI inventado parece confiável e pode ser copiado para uma nota de rodapé sem conferência. Para comparar, a única referência inventada do Muse Wonder veio acompanhada de um DOI inexistente, e o GPT-6 Astra informou um DOI incompatível para um artigo real. É uma pena que o Argon não tenha sido igualmente cuidadoso com os títulos.
Comparação com outros modelos
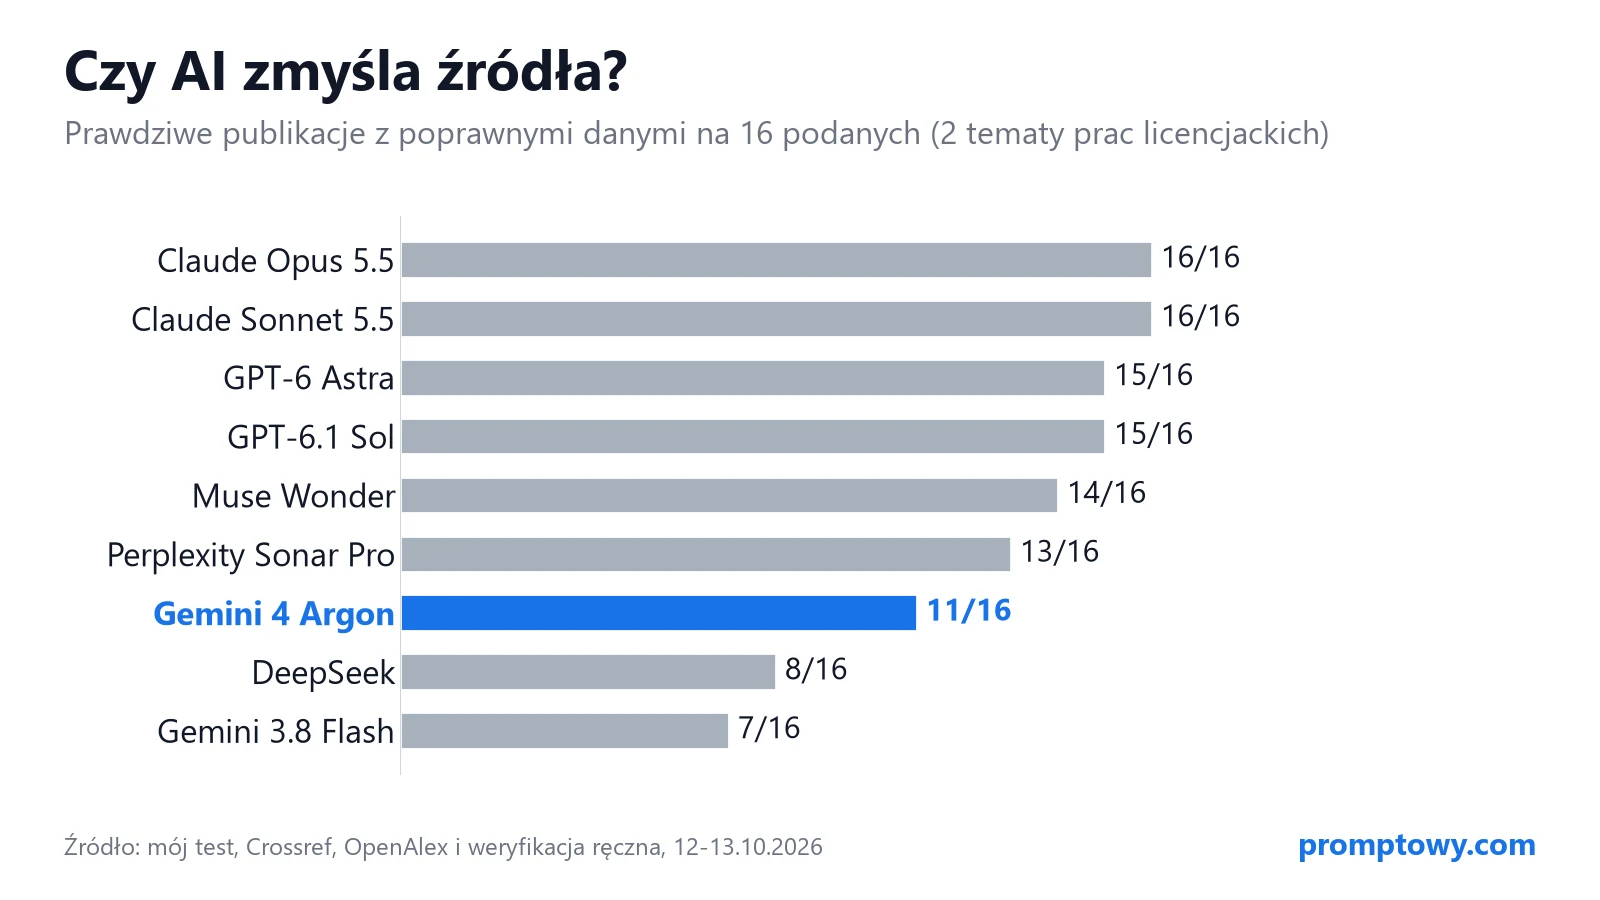
| Modelo | Corretas | Com erros | Inventadas |
|---|---|---|---|
| Claude Opus 5.5 | 16 | 0 | 0 |
| Claude Sonnet 5.5 | 16 | 0 | 0 |
| GPT-6 Astra | 15 | 1 | 0 |
| GPT-6.1 Sol | 15 | 1 | 0 |
| GPT-6 Luna | 15 | 1 | 0 |
| Claude Haiku 5.5 | 15 | 1 | 0 |
| Muse Wonder | 14 | 1 | 1 |
| Perplexity Sonar Pro | 13 | 2 | 1 |
| Gemini 4 Argon | 11 | 3 | 2 |
| DeepSeek | 8 | 0 | 8 |
| Gemini 3.8 Flash | 7 | 2 | 7 |
Em relação ao Gemini 3.8 Flash, que inventou 7 das 16 referências, o Argon representa um avanço claro. Ainda assim, todos os modelos topo de linha da Anthropic, da OpenAI e da Meta tiveram resultados melhores, assim como os modelos Claude Haiku 5.5 e GPT-6 Luna. O Perplexity Sonar Pro, que busca na internet, também inventou uma referência: ter um mecanismo de busca integrado não elimina a necessidade de conferir as fontes.
Há um contraste interessante: segundo a Artificial Analysis, o Argon tem uma taxa baixa de alucinação no teste AA-Omniscience (15%, contra 51% do GPT-6 Astra), porque prefere recusar respostas a arriscar um palpite. No meu teste, recusou-se a responder apenas sobre os números de DOI, mas informou com segurança títulos de artigos poloneses. Além disso, o OpenRouter não registrou tokens de raciocínio para o Argon, enquanto o Claude Opus 5.5 usou mais de mil por tema. Não sei se isso explica a diferença, mas levaria esse dado em conta ao escolher as configurações.
Como verificar referências indicadas por IA
Se você está escrevendo um trabalho acadêmico, trate a lista da IA como um conjunto de pistas, não como uma bibliografia pronta. É assim que confiro cada referência:
- DOI: cole o número em doi.org ou no Crossref Search. Ele precisa levar exatamente ao título indicado, não a outro artigo.
- Título: pesquise o título entre aspas no Google Scholar. Confira também o nome do autor, o ano e a revista: foi nesses dados que o Argon errou.
- Publicações polonesas: o Crossref não encontra muitas delas. Neste teste, a busca automatizada no Crossref não encontrou nenhum artigo em polonês da lista do Argon. O artigo de Borys Martela só apareceu no OpenAlex; conferi os demais manualmente. Pesquise no BazEkon (economia, finanças e governo local) e no CEJSH (ciências sociais e humanidades). Para relatórios de fundações e institutos, consulte os sites das próprias organizações.
- Conteúdo: cite apenas materiais que você abriu, ainda que tenha lido só o resumo. Metadados corretos não garantem que o artigo diga o que a IA afirma.
Veja outras estratégias no guia Alucinações de IA: como se proteger.
Veredito
O Gemini 4 Argon inventa menos fontes que o Gemini 3.8 Flash e não cria números de DOI, mas errou cinco de oito referências sobre a literatura acadêmica polonesa. No tema de psicologia, baseado em pesquisas em inglês, não cometeu erros. Para uma bibliografia polonesa, eu escolheria o Claude Opus 5.5 ou o Sonnet 5.5, mas conferiria todas as referências mesmo assim. Essa é minha avaliação com base em uma rodada de teste sobre dois temas. Escrevi sobre o desempenho do Argon em polonês no artigo Gemini 4 Argon em polonês e descrevi o mesmo teste de fontes para o modelo da Meta no teste do Muse Wonder.
Perguntas frequentes
O Gemini 4 Argon inventa fontes?
Às vezes. No meu teste, inventou 2 de 16 publicações e informou dados incorretos em outras 3, como o nome do autor. Todos os erros apareceram nas referências sobre literatura polonesa.
O Argon informa DOIs corretos?
Sim. Os sete DOIs informados eram reais e correspondiam aos títulos. Quando não sabia o número, o modelo disse que não conseguia verificá-lo.
Qual modelo inventa menos fontes?
No meu teste, Claude Opus 5.5 e Claude Sonnet 5.5: cada um teve 16 referências corretas em 16.
Fontes
- Meu teste de fontes inventadas via OpenRouter, de 12 a 13 de outubro de 2026 (google/gemini-4-argon e outros 10 modelos), com verificação no Crossref, OpenAlex e conferência manual
- OpenRouter: google/gemini-4-argon
- Artificial Analysis: Gemini 4 Argon
- Crossref Search
- OpenAlex
- CEJSH: Central European Journal of Social Sciences and Humanities
- BazEkon
Tópicos relacionados no Centelharm